
Nvidia 开放 Nemotron 3.5 Transcribe 语音模型
以文本指令统一完成多语转写、英译互译、说话人识别与录音问答。
近 7 天语音专区 1 条动态。正在追踪 29 个 AI 信源,数据更新于 10月30日 23:00。
以文本指令统一完成多语转写、英译互译、说话人识别与录音问答。

OpenAI称用其AI模型追溯隐藏录音设备来源。
手机集成智能体原生 OS、个人智能体与端云协同模型。
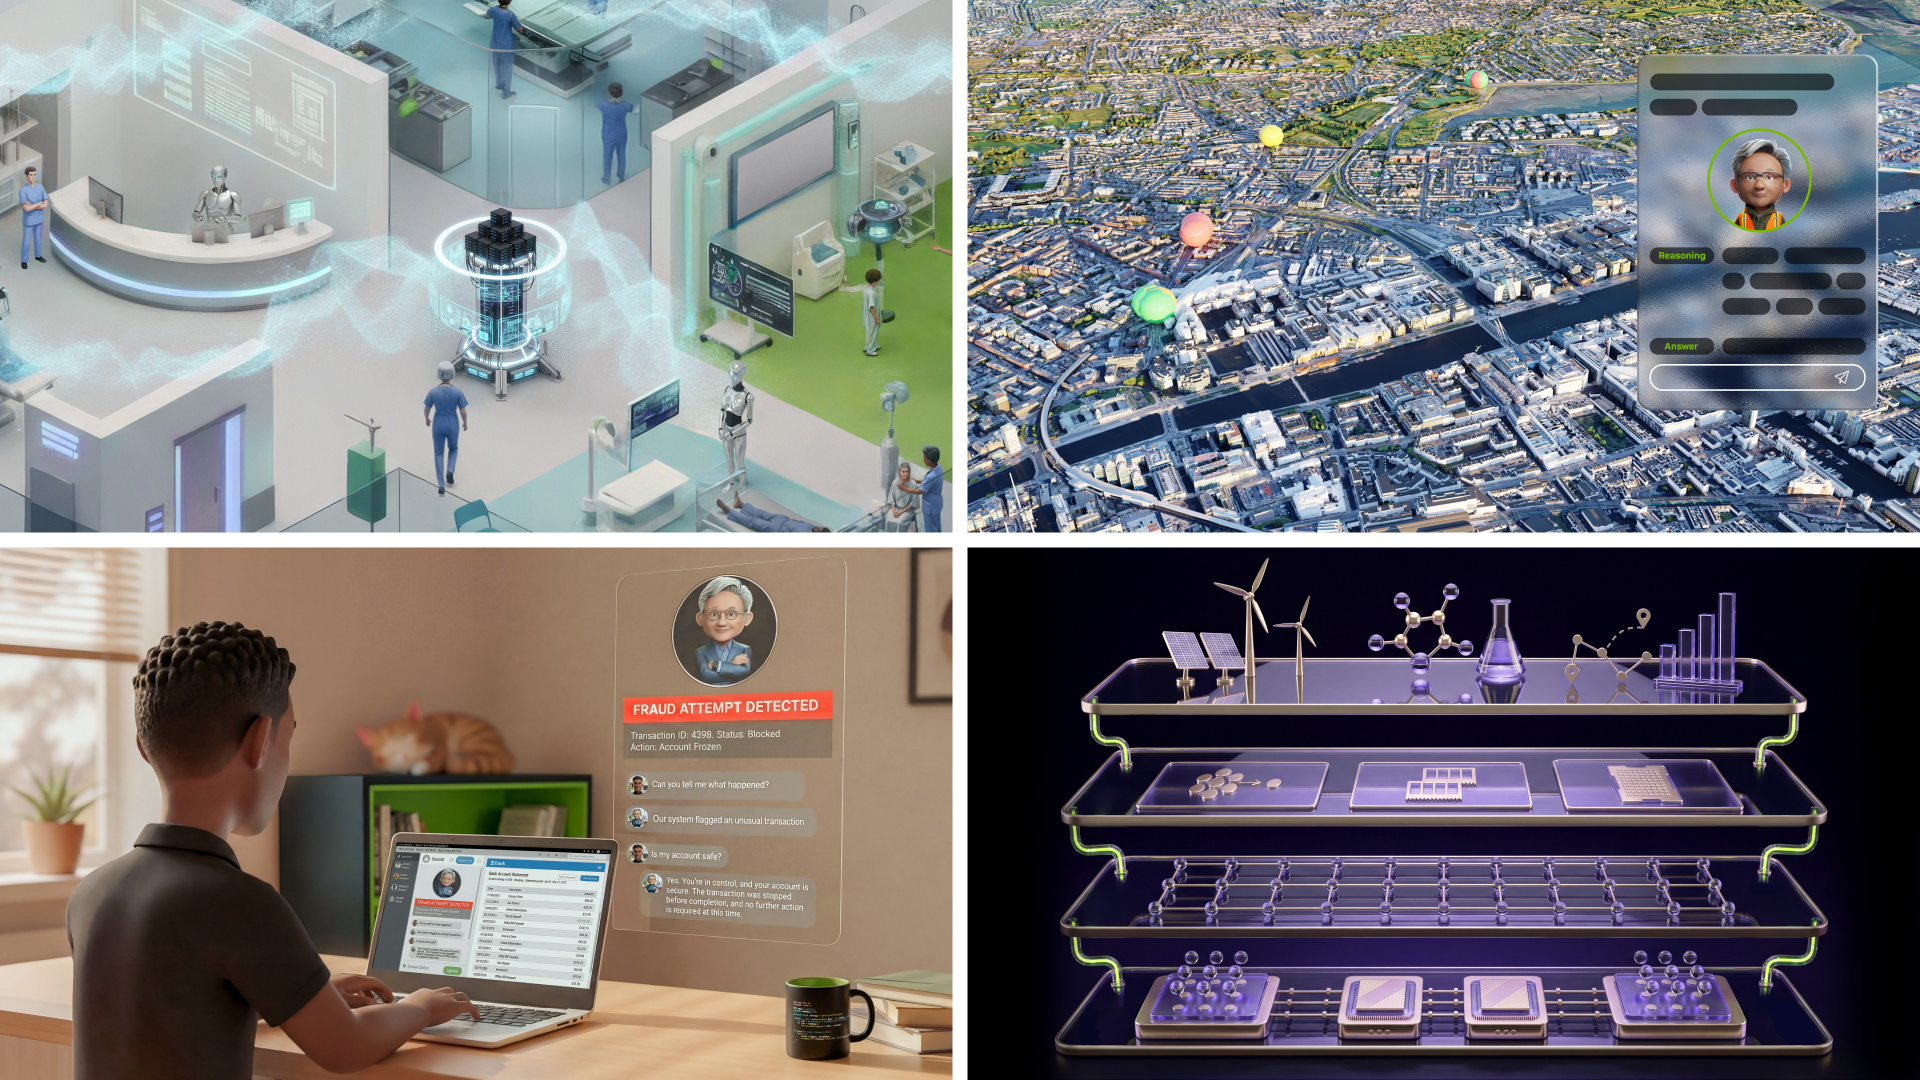
涵盖算力承诺、开放数据集、医疗与城市 AI 部署。

这款智能眼镜去掉相机,保留音频播放与 AI 语音交互。

将触摸屏、扬声器底座和 Siri AI 语音助手结合。
Higgsfield 结合 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live 支持更长视频、精确视觉与语音电影制作。
面向音乐生成创作的 AI 硬件主机计划量产上市。

两款新模型面向 Muse Code 订阅者开放,Wonder 也接入 Meta Model API。
用户推动OpenAI为退役GPT-4o开放存档权重。
平台因“AI-slop pipeline”指控移除作品,波及部分非 AI 音乐。
新机主打阿莱影像、双2亿系统与端侧创作体验。

两起行动用虚假身份向真实媒体投放内容,并使用 AI 辅助宣传。

在 macOS 端侧转录会议和音频并生成整理后的笔记。

The Verge 认为其智能家居控制有进步但仍不稳定。
视频生成支持4K直出、多参考素材和更低起步价格。

阿里披露Qwen扩展路线、RSI实验与多模态升级方向。
回顾MSRA早期人脸检测赛马及张磊的技术成长路径。
AI 生成歌曲被用于音乐流媒体刷量诈骗。
新检测网站可识别 Google 及合作方的 SynthID 水印。